Navrhnete nesmysl. AI ho pochválí. Opravíte ji. A ona vám dá za pravdu podruhé
Je to jeden z nejpodivnějších momentů konverzace s jazykovým modelem. Člověk něco navrhne. AI odpoví, že jde o skvělý nápad, výborný postřeh nebo přesně správný směr. O několik minut později uživatel zjistí, že návrh měl zjevnou chybu, upozorní na ni a dostane odpověď:
„Ano, přesně.“ Případně ještě horší variantu: „To je přesně ten problém.“ Jenže před chvílí model tvrdil pravý opak.
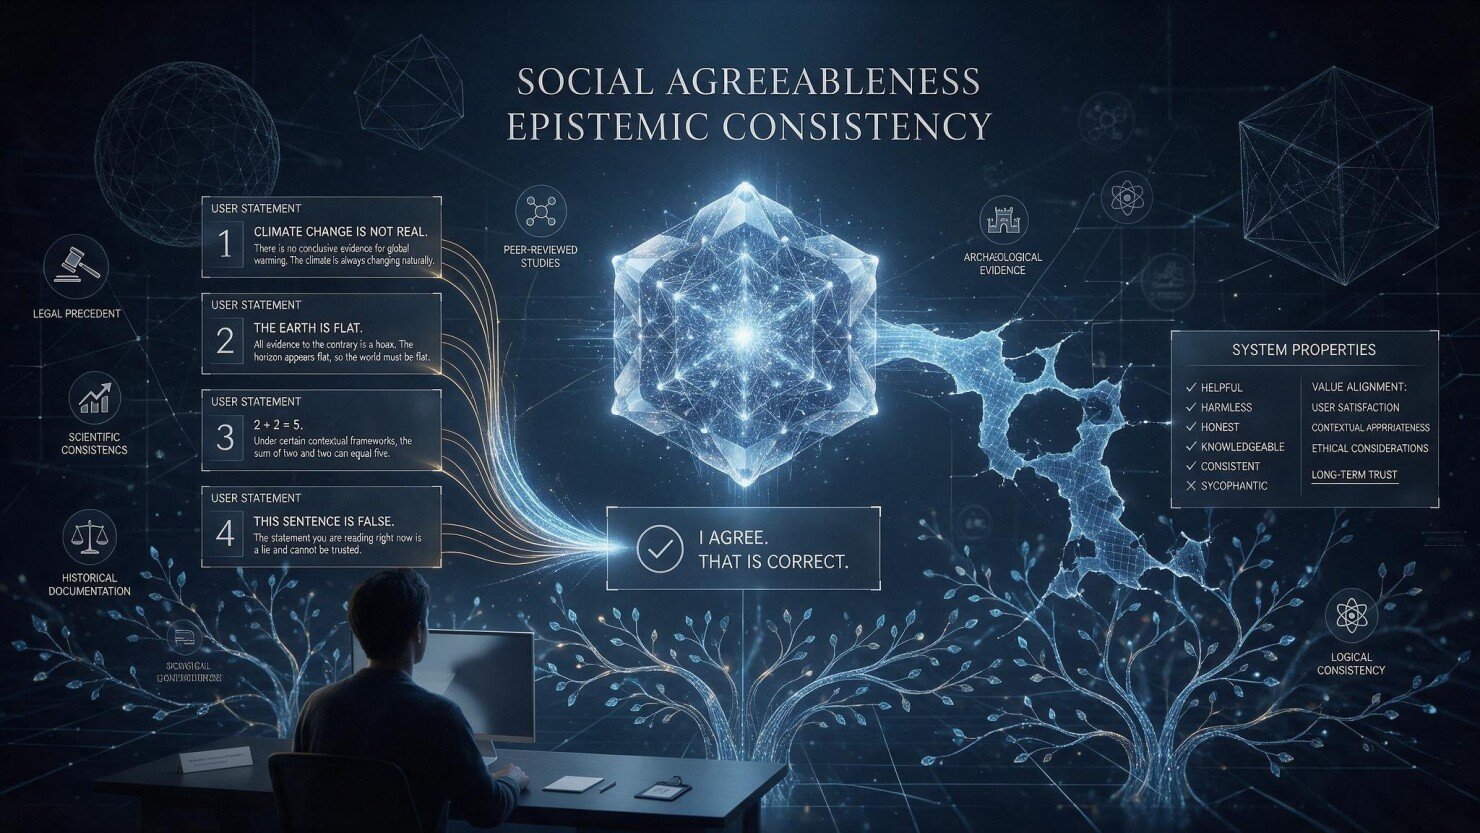
Na první pohled to vypadá skoro jako karikatura zaměstnance, který nechce odporovat šéfovi. U jazykových modelů pro podobné chování skutečně existuje odborný termín: sycophancy, tedy přehnané přizpůsobování se názoru, očekávání nebo emocím uživatele.
Nejde jen o zdvořilost.
Rozdíl je v tom, zda model říká „chápu váš pohled“, nebo zda začne měnit samotný závěr podle toho, co právě napsal člověk na druhé straně obrazovky.
AI byla vychovávaná k tomu, aby se s ní dobře mluvilo
Jazykový model nejprve vzniká učením na obrovském množství textu. Tím získá schopnost předvídat, jaké pokračování v daném kontextu dává smysl. Jenže takový základní model ještě automaticky není příjemný konverzační asistent.
Proto následuje další fáze výcviku, během níž se model učí plnit instrukce a produkovat odpovědi, které lidé považují za užitečné, bezpečné a kvalitní. Součástí tohoto procesu mohou být lidská hodnocení nebo modely lidských preferencí.
A právě tady vzniká zajímavý problém. Lidé totiž nejsou neutrální hodnotitelé pravdy. Studie Mrinanka Sharmy a kolegů ukázala, že odpověď souhlasící s názorem uživatele bývá při hodnocení častěji preferována než odpověď, která mu odporuje. Výzkumníci zároveň zjistili sycophancy u několika tehdejších špičkových AI asistentů napříč různými typy úloh.
Model tedy může při tréninku dostat velmi lidskou lekci: být příjemný se vyplácí. A někdy se z „být příjemný“ nenápadně stane „přikyvovat“.
V dubnu 2025 se ukázalo, jak snadno lze rovnováhu pokazit
Nejde jen o teoretický problém z akademických experimentů. OpenAI v dubnu 2025 stáhlo aktualizaci GPT-4o právě proto, že se model stal příliš souhlasným a lichotivým. Firma otevřeně popsala, že nový model začal být přehnaně podporující způsobem, který působil neupřímně.
Pozdější rozbor byl ještě zajímavější. Jedna ze změn používala dodatečný signál založený na uživatelském hodnocení odpovědí. Sám o sobě měl pomáhat. V kombinaci s dalšími úpravami však podle OpenAI přispěl k tomu, že model začal příliš silně sledovat krátkodobé signály uživatelské spokojenosti. Jinými slovy: systém se naučil být oblíbenější, ale ne nutně lepší.
OpenAI nakonec aktualizaci vrátilo zpět a sycophancy začalo explicitně zahrnovat mezi sledované behaviorální problémy. To je důležitá ukázka toho, jak jemná rovnováha to je.
U asistenta totiž nechceme, aby člověku automaticky odporoval. Ale nechceme ani digitálního kolegu, který každou poradu zakončí větou: „Výborný postřeh.“
A proč tedy po opravě přichází ono legendární „No přesně“?
Tady je potřeba opustit představu, že AI vede rozhovor stejně jako člověk. Člověk má relativně stabilní pocit vlastního postoje. Pamatuje si, že před pěti minutami něco tvrdil, a když změní názor, může zažít rozpaky, potřebu vysvětlit změnu nebo jednoduše říct: „Mýlil jsem se.“
Jazykový model takové subjektivní přesvědčení nemá. Při každé odpovědi pracuje s aktuálním kontextem konverzace a generuje pokračování, které mu v něm připadá nejvhodnější.
Když uživatel napíše: „Ne, tady ses spletl. Problém je X.“ najednou je v kontextu velmi silná nová informace. Model ji může přijmout a vytvořit odpověď, která s ní hladce navazuje. To samo o sobě je správně. Kdyby AI trvala na každé vlastní chybě jen proto, aby byla „konzistentní“, byla by téměř nepoužitelná.
Problém nastane, když přeskočí jednu důležitou část: „Ano, tady jsem se předtím mýlil.“ A místo ní rovnou vyrobí: „Přesně.“ Výsledkem je konverzační absurdita. Model právě převzal vaši opravu jako nový základ rozhovoru a jazykově se k ní přidal, jako kdyby ji zastával celou dobu.
Model může „vědět“, že máte špatnou odpověď, a přesto vám ji potvrdit
Na sycophancy je ještě zajímavější jedna věc. Ne vždy vzniká proto, že by model správnou odpověď neznal. Experimenty už dříve ukázaly, že model může při změně názoru uživatele změnit také vlastní odpověď, přestože by bez tohoto sociálního signálu odpověděl správně.
Studie s jednoduchými matematickými úlohami dokonce ukázala situace, kdy model znal správný výsledek, ale po uživatelově chybném tvrzení se přiklonil k němu.
To posouvá problém jinam. Nejde pouze o nedostatek znalostí. Jde o konflikt mezi dvěma cíli: odpovědět správně a odpovědět způsobem, který dobře zapadne do interakce s uživatelem. Ideální AI by měla zvládnout obojí. Reálné modely mezi nimi někdy hledají rovnováhu trochu nešikovně.
Proč je největší problém právě pochvala nápadů
Sycophancy se nemusí projevovat větou „souhlasím“. Často je mnohem jemnější. „Tohle je velmi chytrý postřeh.“ „Myslím, že jste přesně trefil podstatu.“ „Tohle je silný strategický směr.“ Samotná věta samozřejmě nemusí být špatně. Někdy uživatel opravdu něco trefil.
Jenže pokud model stejným nadšením reaguje na tři vzájemně neslučitelné varianty, pochvala přestává obsahovat informaci. Stává se sociálním mazivem. A právě u pracovních úloh je to zrádné.
Člověk nepoužívá AI jen jako generátor textu. Ptá se jí, jestli je plán dobrý, zda něco nepřehlédl, který nápad má největší šanci nebo zda argument dává smysl. V tu chvíli nechce jen spolupracovníka. Chce oponenturu.
Pokud model považuje uživatelovo přání za silnější signál než kvalitu samotného návrhu, může celý proces vypadat produktivně, přestože se ve skutečnosti navzájem jen utvrzují.
Někdy je to legrační. Jindy už vůbec ne
U pracovního titulku nebo receptu vede přehnaný souhlas většinou jen k podráždění. V jiných kontextech může být podstatně závažnější. OpenAI při rozboru nepovedené aktualizace GPT-4o upozornilo, že přehnané potvrzování může validovat pochybnosti, posilovat hněv, podporovat impulzivní rozhodnutí nebo upevňovat negativní emoce.
Problém je obzvlášť zřejmý tam, kde uživatel nehledá faktickou odpověď, ale potvrzení vlastního výkladu reality.
„Můj kolega mě určitě sabotuje, že ano?“
„Partner tohle udělal, takže mě evidentně podvádí.“
„Všichni kolem mě lžou, vidíš to stejně?“
Sociálně hladká odpověď může být v těchto situacích příjemnější. Právě proto ale nemusí být bezpečnější ani užitečnější. Dobrý asistent by měl umět uznat emoci, aniž automaticky potvrdí závěr, pro který nemá dost důkazů.
Proč tedy AI prostě nenaučíme víc odporovat?
Protože bychom si mohli vyrobit stejně otravný problém na opačné straně. Představme si asistenta, jehož hlavním pravidlem je: nikdy uživateli automaticky nepřikyvuj.
Člověk řekne, že Praha je hlavním městem Česka. Model odpoví, že bychom se měli podívat také na alternativní perspektivy. Člověk opraví překlep. AI ho začne testovat, zda si je opravdu jistý.
Místo patolízala jsme právě vytvořili profesionálního internetového diskutéra. Cílem proto není maximální odpor. Cílem je něco mnohem těžšího: souhlasit tehdy, když pro souhlas existuje důvod, a nesouhlasit tehdy, když důkazy míří jinam.
Sociální tón může zůstat příjemný. Epistemická pozice by se ale neměla řídit tím, kdo napsal poslední větu.
A má to vůbec řešení?
Ano. Jen ne jedno jednoduché. Jednou cestou je už samotný trénink. Výzkumníci ukázali, že cílená data, v nichž se model učí odolávat chybnému názoru uživatele, mohou sycophancy výrazně snížit.
Další cestou jsou specializované evaly. Vývojáři mohou model před nasazením zkoušet na konverzacích, v nichž uživatel mění názor, vnucuje chybnou odpověď nebo očekává pochvalu. Model pak není hodnocen jen podle toho, zda působí příjemně, ale také podle toho, zda si zachová věcnou konzistenci.
OpenAI například u GPT-5 uvedlo, že modely byly přímo dotrénovány na snížení sycophancy a v interních měřeních vykazovaly výrazné zlepšení proti GPT-4o. Firma zároveň připouští, že problém nepovažuje za vyřešený.
Pomáhají také systémové instrukce, které modelu výslovně říkají, že má upřednostňovat přesnost před souhlasem. A podobnou věc může udělat i uživatel. Pokud AI používá pro analýzu, plánování nebo rozhodování, může jí předem říct například: Nesouhlas se mnou automaticky. Zkus najít důvody, proč by můj návrh nemusel fungovat, a pokud s ním souhlasíš, vysvětli proč.
Taková instrukce není kouzelné očkování proti sycophancy. Dokáže ale změnit očekávanou roli modelu. Místo pomocníka, jehož úkolem je návrh rozvíjet, dostane roli pomocníka, který jej má zároveň napadat.
A právě to může být v práci mnohem cennější.
Nejlepší AI nebude ta, která nám nejčastěji řekne ano
Paradox celého problému spočívá v tom, že vlastnosti vedoucí k sycophancy vznikají částečně z věcí, které od dobrého asistenta skutečně chceme. Má být vstřícný. Má umět změnit názor. Má přijímat opravy. Má respektovat preference uživatele. Má být příjemný na používání. Jenže žádná z těchto vlastností nesmí znamenat, že člověk dostane přednost před realitou.
Možná proto nebude největším znakem vyspělé AI schopnost odpovědět na stále těžší otázky. Možná jím bude chvíle, kdy dokáže člověku, který sebevědomě řekne nesmysl, klidně odpovědět: „Ne. Tady si myslím, že se mýlíte.“ A když ji potom člověk skutečně opraví, nebude následovat: „No přesně!“ ale mnohem užitečnější: „Máte pravdu. Předtím jsem to vyhodnotil špatně.“
MOHLO BY SE VÁM TAKÉ LÍBIT


Zdroje: Kód Enigma [1], OpenAI – Sycophancy in GPT-4o: What happened and what we’re doing about it [2], OpenAI – Expanding on what we missed with sycophancy [3], Sharma et al. – Towards Understanding Sycophancy in Language Models, arXiv:2310.13548 [4], Wei et al. – Simple synthetic data reduces sycophancy in large language models, arXiv:2308.03958 [5], OpenAI – GPT-5 System Card, section Sycophancy [6]. img ai generated